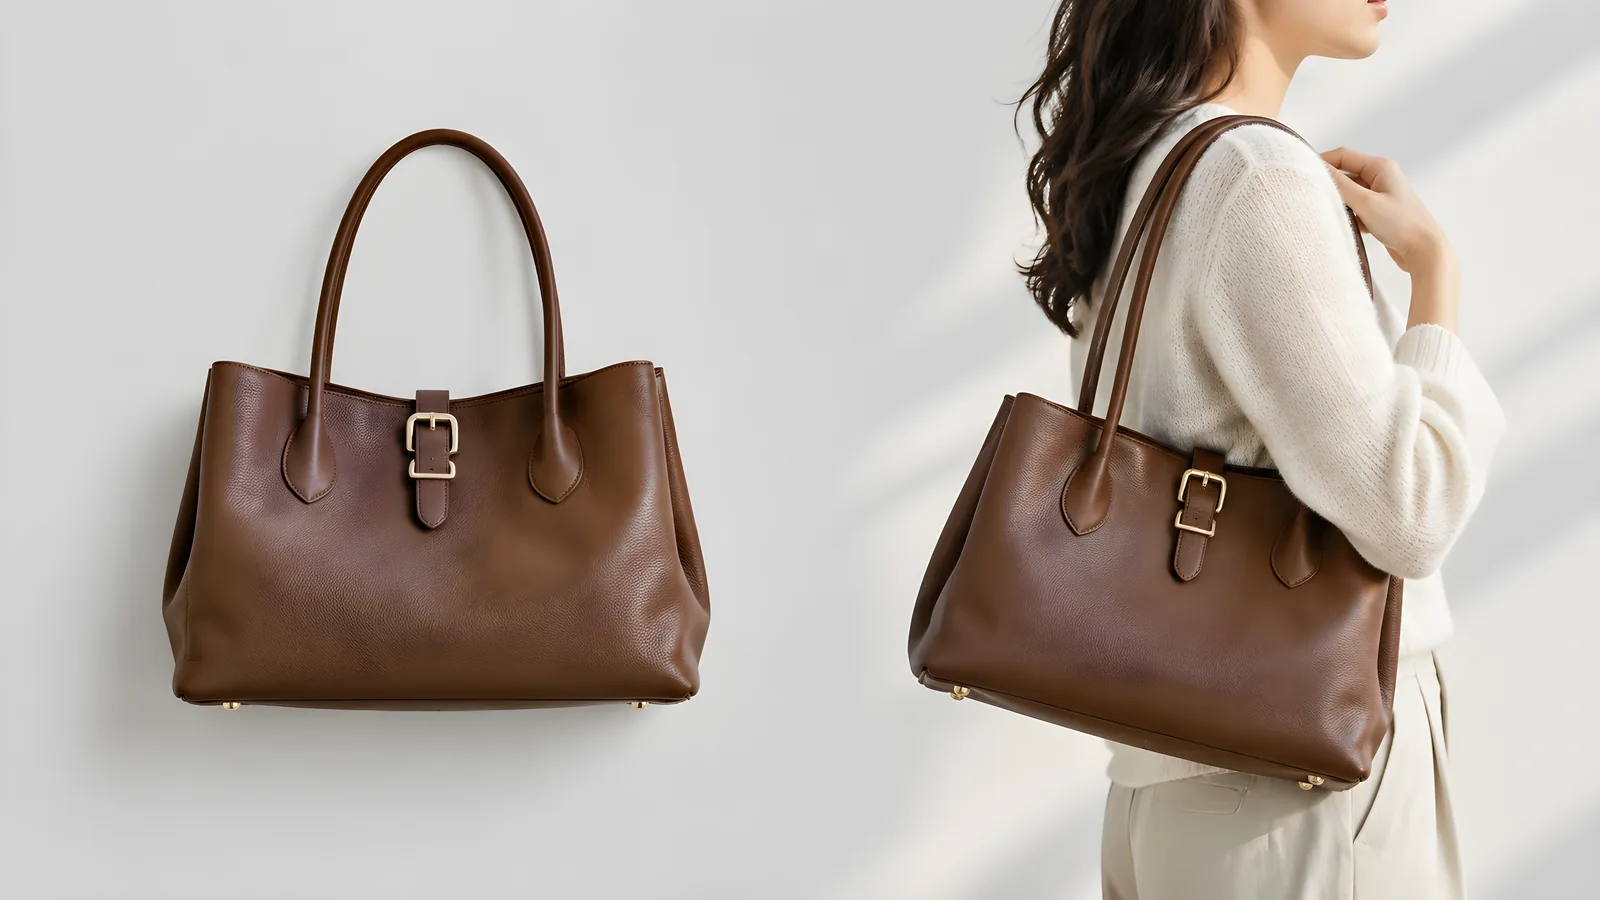
先给判断线:包、帽子、腰带、围巾这类"轮廓大、结构简单"的配饰,用生成的上身图性价比最高;戒指、耳环这类需要极近特写的小件,以及有可读 logo、五金件精密的款,建议实拍。 服装鞋包店铺的一个可落地配比是:主推款实拍一组,同款配色和搭配变体全部生成。 下面按配饰品类分档说。
按配饰品类分档
| 配饰类型 | 建议方式 | 关键原因 |
|---|---|---|
| 手袋 / 背包 | 生成为主 | 轮廓大、挎背姿势固定,生成稳定 |
| 帽子 | 生成为主 | 与头型的贴合关系简单 |
| 腰带 / 围巾 | 生成为主 | 搭配场景多,实拍重复劳动大 |
| 墨镜 | 混合 | 镜面反射和鼻托贴合容易出问题 |
| 手表 | 实拍优先 | 表盘刻度与文字必须准确 |
| 项链 / 耳环 / 戒指 | 实拍优先 | 依赖极近特写,小件细节要求高 |
判断逻辑只有一条:买家要靠这张图确认"戴上是什么效果"的,生成够用;要靠它确认"做工细不细"的,得实拍。
实拍的四条红线
- 五金件有品牌标识。锁扣、拉头、扣针上的 logo,生成容易出错,而这恰是买家判断真假的地方;
- 表盘、刻度、文字。手表和有印字的配饰,模型写字不可靠;
- 材质是溢价理由。真皮的毛孔、编织的纹路,生成容易被美化成塑料感;
- 精密结构。链条的扣环结构、卡扣的开合方式,有规则重复结构的部位要放大数一遍才能用。
踩到任一条,实拍更省事。
生成的实际操作流程
用 PixGT 流光AI 的配饰穿戴功能,输入和参数都很明确:
输入:配饰图必填,最多可传 3 张;模特图、场景图、模特参考图都是可选的。
参数:
- 配饰标签 11 类:包、眼镜、项链、耳环、戒指、手链、手表、帽子、发饰、腰带、其他。选对标签,系统才知道该把它放在身体的哪个位置;
- 模特 4 档:上传模特图、随机、从模特库选、自定义描述;
- 景别 5 档:按配饰自动、跟随原图、局部特写、半身、全身;
- 场景 5 档;
- 多张差异 3 档:每张角度不同、每张场景不同、构图一致(默认为角度不同)。
输出:模特佩戴该配饰的成品图。你不需要写提示词,系统根据槽位和参数自行组织。
这里最值得注意的是"景别":默认的"按配饰自动"会根据配饰类型选合适的取景范围——包给半身、戒指给局部特写。想统一整组图的取景范围时再手动指定。
生成比实拍强在哪
- 不用约模特。实拍的成本大头往往不是拍摄,是约人、妆造、场地和排期。旺季前约档期两周起是常态;
- 同款多配色一次性铺开。一个包五个颜色,实拍是拍五轮,生成是换五次输入;
- 搭配场景可以堆。同一只包配通勤、约会、旅行三种场景,只需要换"场景"参数;
- 模特多样性容易做。模特库可按性别、年龄、地区筛选,做多地区站点的素材时很实用。
混合方案怎么落地
给一个可以直接照做的分工:
- 主推款:实拍一组完整的(正面、侧面、细节特写、上身)。这是门面,也是后续生成的基准;
- 同款配色变体:全部生成。把实拍图的色温和背景基调作为参考,让生成的图向实拍靠;
- 搭配场景图:全部生成。这类图买家看的是氛围和比例关系,不看做工;
- 细节特写:一律实拍。
这个分工的核心是:同一款商品里,“证明做工"的图实拍,“展示效果"的图生成。两种方案比较的具体维度,SHEIN 服装鞋包配饰上身图和实拍的对比从平台角度补了一些;批量场景的组织方式可以看TikTok 配饰上身图怎么批量生成。
FAQ
Q:配饰穿戴一次最多能传几张配饰图?
最多 3 张。多张时可以用"多张差异"参数控制产出是角度不同、场景不同还是构图一致。
Q:必须提供模特图吗?
不必须。模特有 4 档可选:上传、随机、从模特库选、自定义描述。没有模特素材时从模特库选最省事。
Q:生成的上身图会不会比例不对?
景别参数默认是"按配饰自动”,会按配饰类型给合适的取景。如果发现比例别扭,先把配饰标签选对——标签错了,系统放置的位置就会错。
Q:戒指、耳环能不能也用生成?
可以生成用于展示搭配效果的图,但这两类主要靠极近特写说服买家,细节图仍建议实拍。
Q:生成的图能直接上架吗?
上架前要逐张核对:五金件的形状、有无乱码文字、有规则重复结构的数量。各平台对 AI 生成内容的标识要求以平台最新公告为准。