先理清这个功能在做什么,素材要求才说得通:图片翻译是识别图上的文字并翻成目标语言、版式不变——本质是 OCR 加就地重排,不是重新生成整张图。 所以它对原图的要求,和"生成一张新图"完全不同:它不在乎构图美不美,只在乎文字看不看得清、周围有没有地方放译文。 输入只有一个必填项(原图 1 张),目标语言支持 16 种:英、简体中文、繁体中文、日、韩、德、法、西、葡、巴西葡、俄、阿拉伯、泰、印尼、越、马来。
必须满足的四个条件
1. 文字必须清晰可辨
OCR 认不出来的字,翻译无从谈起。判断方法很直接:把图放大到 100%,你自己能不能一眼读出每个字。 读不出来的,系统也读不出来。
常见不合格的情况:截图后二次压缩导致文字发虚、手机拍详情页再裁切、从视频里截的帧。这些图的文字边缘都是糊的。
怎么改:找原始设计稿或原始尺寸的图,不要用压缩过、转存过多次的版本。
2. 文字与背景要有足够对比
浅灰字压在浅色渐变上、白字压在亮色照片上、文字上面盖了半透明色块——这些情况 OCR 的识别率会明显下降。
判断方法:把图转成灰度看一眼,文字还能不能从背景里跳出来。
3. 译文要有地方放
这一条最容易被忽略,也最常见。同一句话在不同语言里的长度差异很大:中文四个字的短语,翻成德语或俄语可能变成两倍长度。原图如果把文字框卡得刚好、一个字的余量都不留,译文就会挤、缩、或者溢出。
怎么改:在设计源图时就给文字区留余量——横向留出约三成空间是比较稳的做法。已经做好的图,如果文字排得极满,翻译后需要人工微调,或者干脆重新排一版再翻。
4. 竖排、艺术字、变形字慎用
竖排中文、严重变形的艺术字、被拉伸或旋转的文字,识别和重排的难度都高。这类图要么换成常规排版,要么接受译文版式可能不理想。
一张可以直接照做的自查清单
- 图片是原始尺寸,没有经过多次压缩转存
- 放大到 100% 每个字都能读清
- 转成灰度后文字仍能从背景中分离
- 每个文字块横向有约三成的余量
- 没有竖排文字和严重变形的艺术字
- 文字上方没有半透明遮罩
- 需要保留的品牌名、型号、单位已单独记录(便于译后核对)
最后一条值得多说一句:品牌名、型号编码、规格单位这类内容不应该被翻译。译后一定要对照原图核一遍,确认这些没被"翻"掉。
素材差会得到什么结果
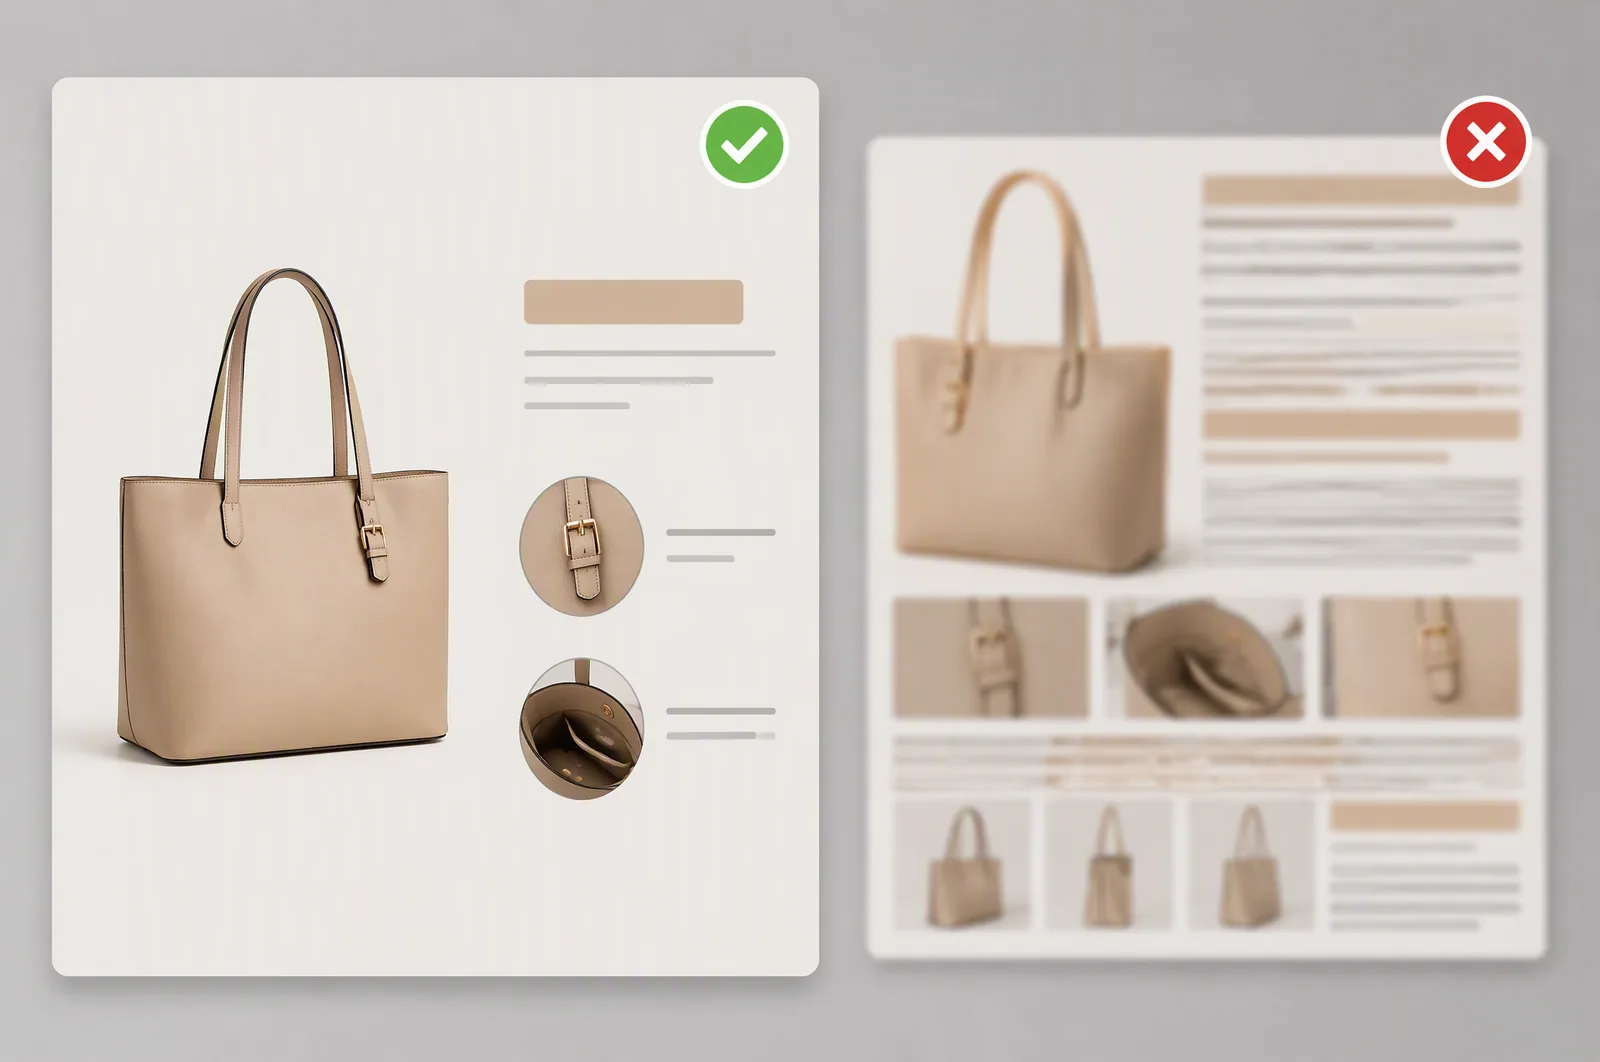
不合格的素材不会直接报错,而是产出"看起来完成了但不能用"的图,这种更麻烦。三种典型表现:
| 素材问题 | 产出表现 |
|---|---|
| 文字发虚 | 部分文字未被识别,原文残留在图上,与译文混排 |
| 对比度不足 | 漏译整块文字 |
| 文字区无余量 | 译文溢出边界,或被压缩到难以阅读 |
| 竖排 / 艺术字 | 版式错乱,文字位置偏移 |
所以拿到成品后的第一件事不是看好不好看,而是逐块比对原图,确认每一块文字都被翻到了、且没有原文残留。
实际操作流程
用 PixGT 流光AI 的图片翻译功能:上传原图(1 张,必填),选目标语言(16 种任选),提交。系统识别图上文字并翻成目标语言,版式保持不变。
输入就这一项,没有其他必填槽位——这也是为什么素材质量几乎决定了全部结果。
一个实用的做法:做多语言站点时,先用一张最典型的详情图跑一遍所有需要的语言,看哪种语言的译文长度最容易溢出,再拿这个结果去反向调整源图的排版。一次调好,后面几十张都省事。
FAQ
Q:图片翻译会重新生成整张图吗?
不会。它识别图上文字并就地重排,版式不变,商品画面本身不动。
Q:支持哪些语言?
16 种:英、简体中文、繁体中文、日、韩、德、法、西、葡、巴西葡、俄、阿拉伯、泰、印尼、越、马来。
Q:一次能传几张?
原图 1 张。多张需要逐张提交。
Q:品牌名会被翻译掉吗?
有可能。译后要对照原图核对品牌名、型号和规格单位这类不该被翻译的内容。
Q:译文太长放不下怎么办?
这是源图排版的问题,不是翻译的问题。源图给文字块留出约三成横向余量即可。已经排满的图需要重排一版。
Q:多语言商品图会因为语言问题被驳回吗?
常见的驳回原因是原文残留、漏译和文字溢出,而不是语言本身。具体排查项可以看多语言商品图审核不通过怎么办;新手上手路径在多语言商品图新手怎么入门。