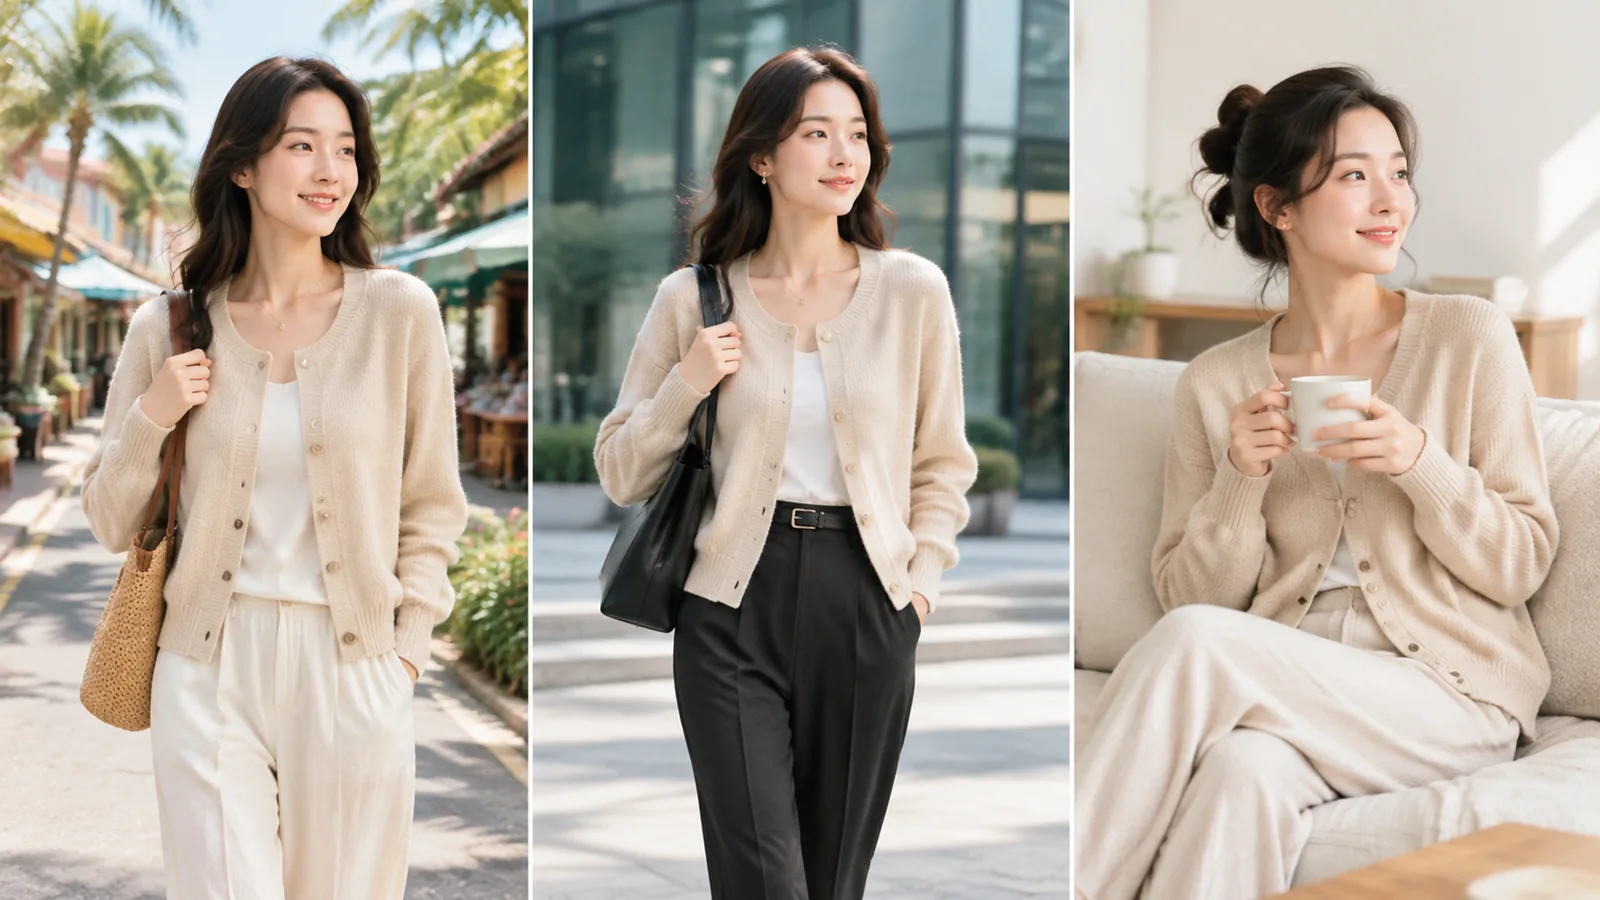
Shopee 多站点做服装鞋包带货视频,正确的顺序是:一套素材出一条"无字幕母片",再按站点分别叠字幕,模特和场景按市场差异单独重出。直接把中文片的字幕换成英文、泰文往上套,是这件事上最常见也最贵的错误——字幕长度会崩、模特与市场不匹配,两头返工。
先分清哪些要换、哪些不用换
| 层级 | 各站点是否需要单独做 | 原因 |
|---|---|---|
| 商品本体画面 | 否 | 同一件衣服,全站点通用 |
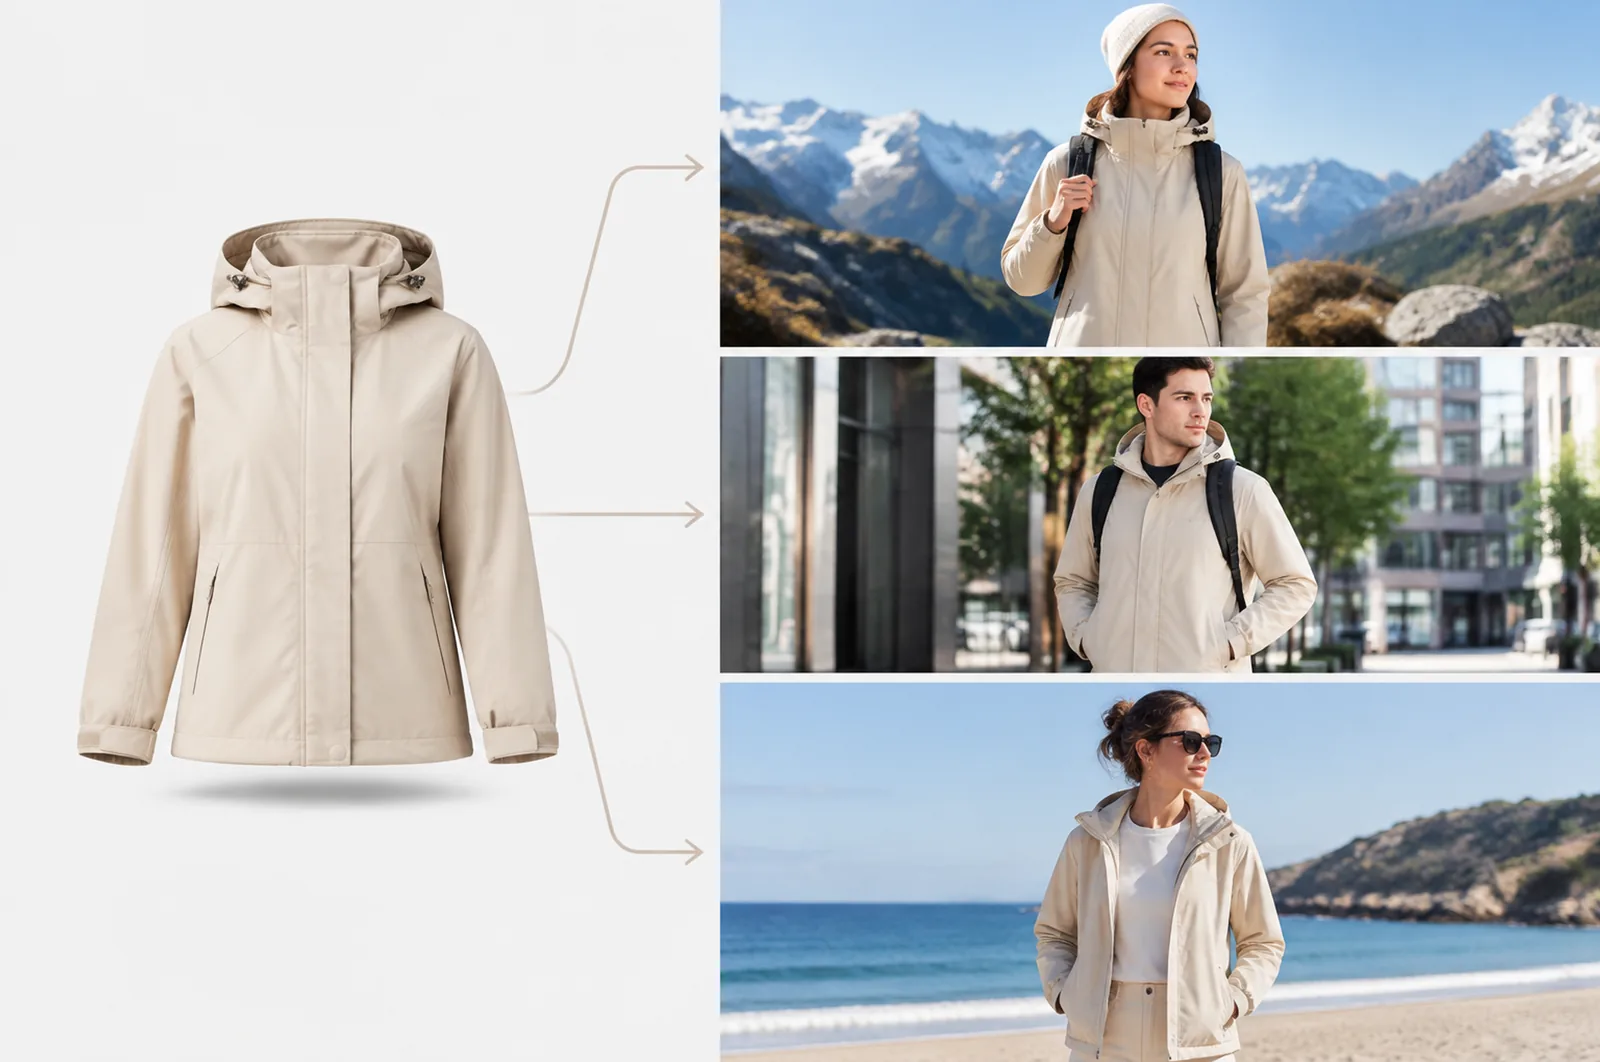
| 模特(肤色/身型) | 是 | 本地买家更认"像自己的人" |
| 场景 | 多数要换 | 气候、街景、室内风格差异大 |
| 字幕文案 | 是 | 语言、长度、阅读习惯都不同 |
| 配乐与节奏 | 建议换 | 各市场对快慢节奏的接受度不同 |
把"商品画面"和"模特/场景"拆开看,工作量会小很多——前者做一次,后者按站点复用同一套卖点重出。
流程:一套素材出多语言版本
- 准备一张合格的服装原图。 平铺图或白底图都行,1000×1000 像素以上,商品完整不被裁切。深色衣服注意别让褶皱糊成一团。
- 写一版不含具体文案的卖点文字。 描述材质、版型、适穿场景,不要写"画面上显示 xx 字"——AI 生成的画面内文字不可控,中文和泰文尤其容易糊。
- 生成母片。 用 PixGT 流光AI 的带货视频功能,上传原图 + 卖点 + 选视频类型即可出片,分镜由系统内部拆解,不用自己写镜头脚本。服装鞋包优先选 UGC 种草或产品演示。
- 按站点重出模特与场景版本。 在卖点文字里加上目标市场的场景描述(比如"东南亚湿热气候下的日常通勤"),重新生成一条。
- 后期叠字幕。 每个站点一版,用剪辑软件叠加,不要交给生成模型。
- 逐条自查再上架。
时长上,服装鞋包用默认档 768P、15 秒(20 点/秒,约 300 点)基本够用;需要完整走一遍上身和细节的,再考虑 Seedance 2.5 的 30 秒档(50 点/秒)。
各市场的审美差异,别靠猜
Shopee 的主力站点差异是真实存在的,做视频时至少注意三点:
- 模特要像本地人。 服装类内容里,模特与买家的相似度直接影响代入感。生成时可以按性别、年龄和地区特征去选,东南亚站点用东亚或本地面孔明显比用欧美面孔更贴。
- 场景要符合气候。 热带站点出现厚外套配落叶街景,观感立刻就"不是给我看的"。马来西亚、印尼、泰国站点优先用室内、商场、夜市、通勤这类全年成立的场景。
- 节奏偏好不同。 同一条片子,有的市场偏好快切多信息,有的偏好慢节奏看质感。这一点没有放之四海的答案,做两版去投,用数据决定。
这些判断本质上属于商业选择,建议拿小预算实测,不要照搬别人的结论。
字幕的三个具体坑
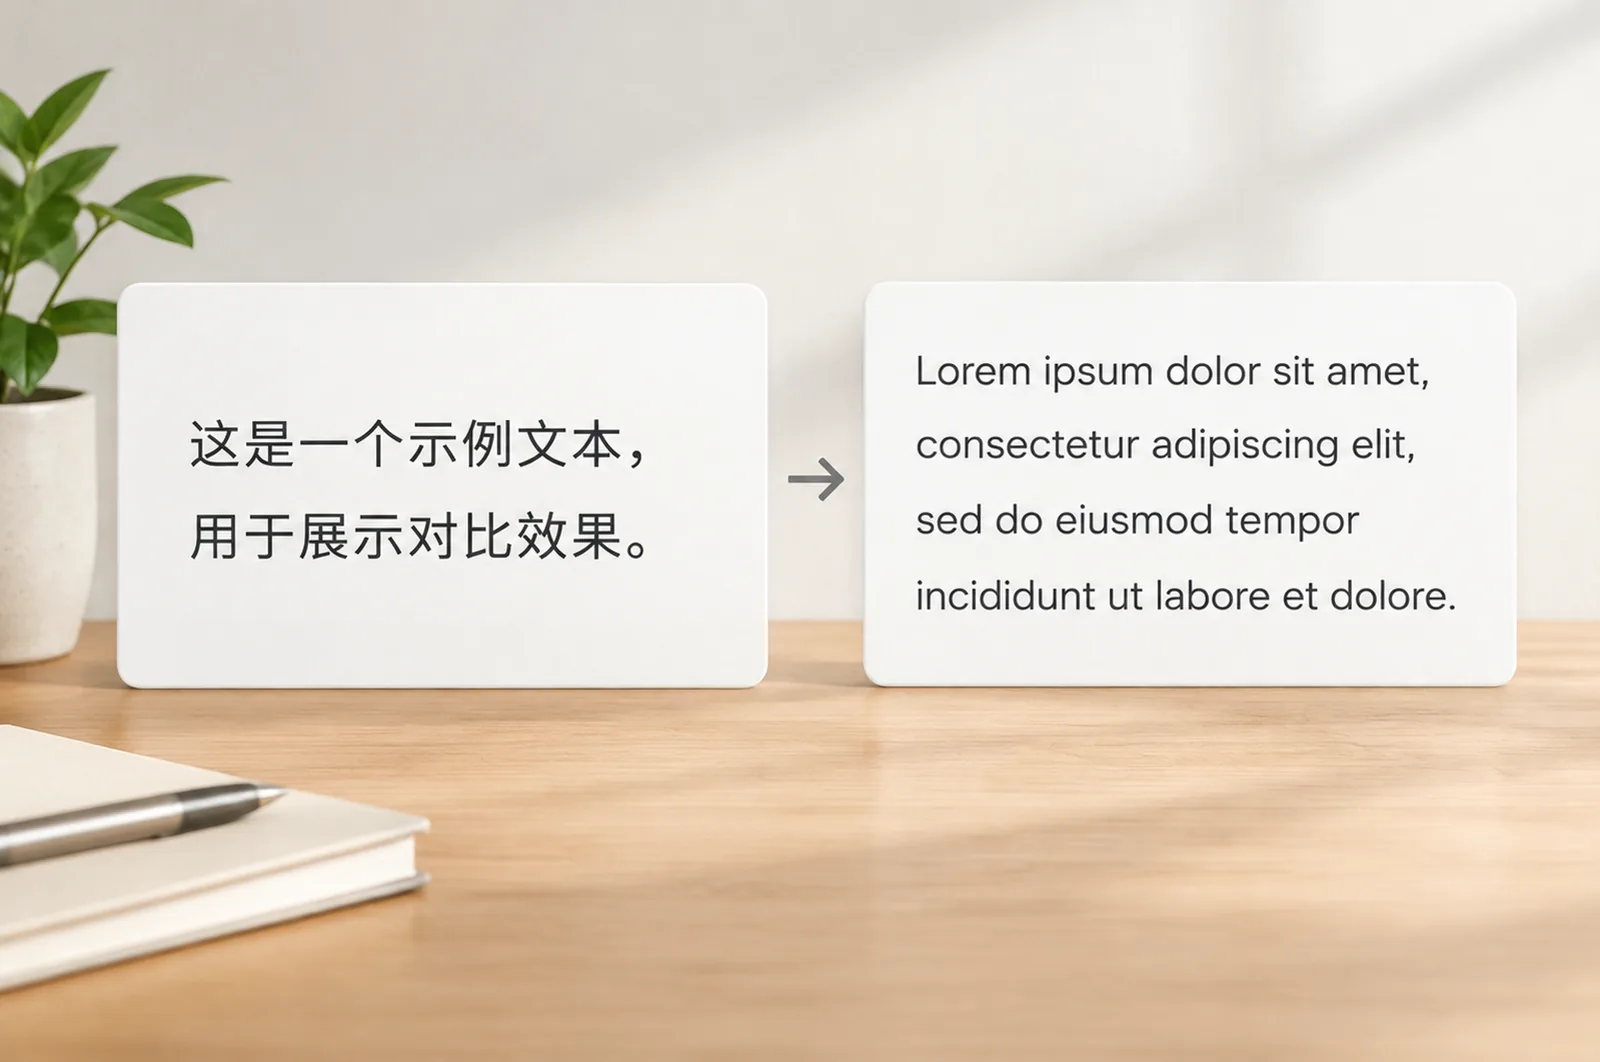
- 换行崩掉。 同一句话,英文比中文长 60%~100%,泰文和越南文还会带上下附加符号占用额外行高。中文字幕设计的两行位置,翻成英文就变四行,直接压到商品上。做法:按最长的那个语种先排版面,再往回套短语种。
- 字体缺字。 泰文、越南文用不带对应字符集的字体会显示成方框或缺声调。剪辑前先确认所选字体支持目标语种。
- 别让模型写字。 想让画面里直接生成外文标题是行不通的,模型写非拉丁字符必出错。文字信息一律后期叠加。
如果需要的是商品图上的文字翻译(主图上的卖点角标、规格说明),那是另一个功能——图片翻译支持 16 种目标语言,做的是识别图上文字并就地重排版式,不是重新生成整张图。视频字幕和图片翻译不要混为一谈。
上线前自查
- 母片里有没有出现任何 AI 生成的文字?
- 各站点版本的模特和场景,有没有和当地气候、面孔明显冲突?
- 最长语种的字幕排版试过了吗?
- 字体支持目标语种的全部字符吗?
- 视频里的材质、颜色和链接主图一致吗?
- 尺码、成分这类信息有没有在视频里写死(各站点表述不同,建议放详情页)?
平台侧的审核要求各站点略有差异,以 Shopee 最新公告为准。
FAQ
Q:能不能只做一条英文片投所有站点? 可以起步,但转化一般。英文片适合作为测试版本,跑出数据后再针对主力站点单独做。
Q:一套素材做 5 个站点要多少点数? 母片 1 条 + 各站点重出 1 条,共 6 条。默认档 15 秒每条约 300 点,合计约 1800 点,字幕后期不额外消耗。
Q:模特能指定地区特征吗? 可以。服装类的模特可以按性别、年龄段和地区(东亚/欧美/非洲)筛选,具体到试穿场景的用法见带货视频需要准备什么素材?前置条件清单里的素材要求部分。
Q:视频里的衣服细节会不会变形? 平铺图上的扣孔、微小五金件在生成中确实容易丢失。关键细节建议单独出特写图放详情页,不要指望视频帧承担细节说明。
Q:多语言版本要分开上架吗? 按站点分开上架,每个站点配对应语言的版本。不要在一个链接里堆多语言视频。