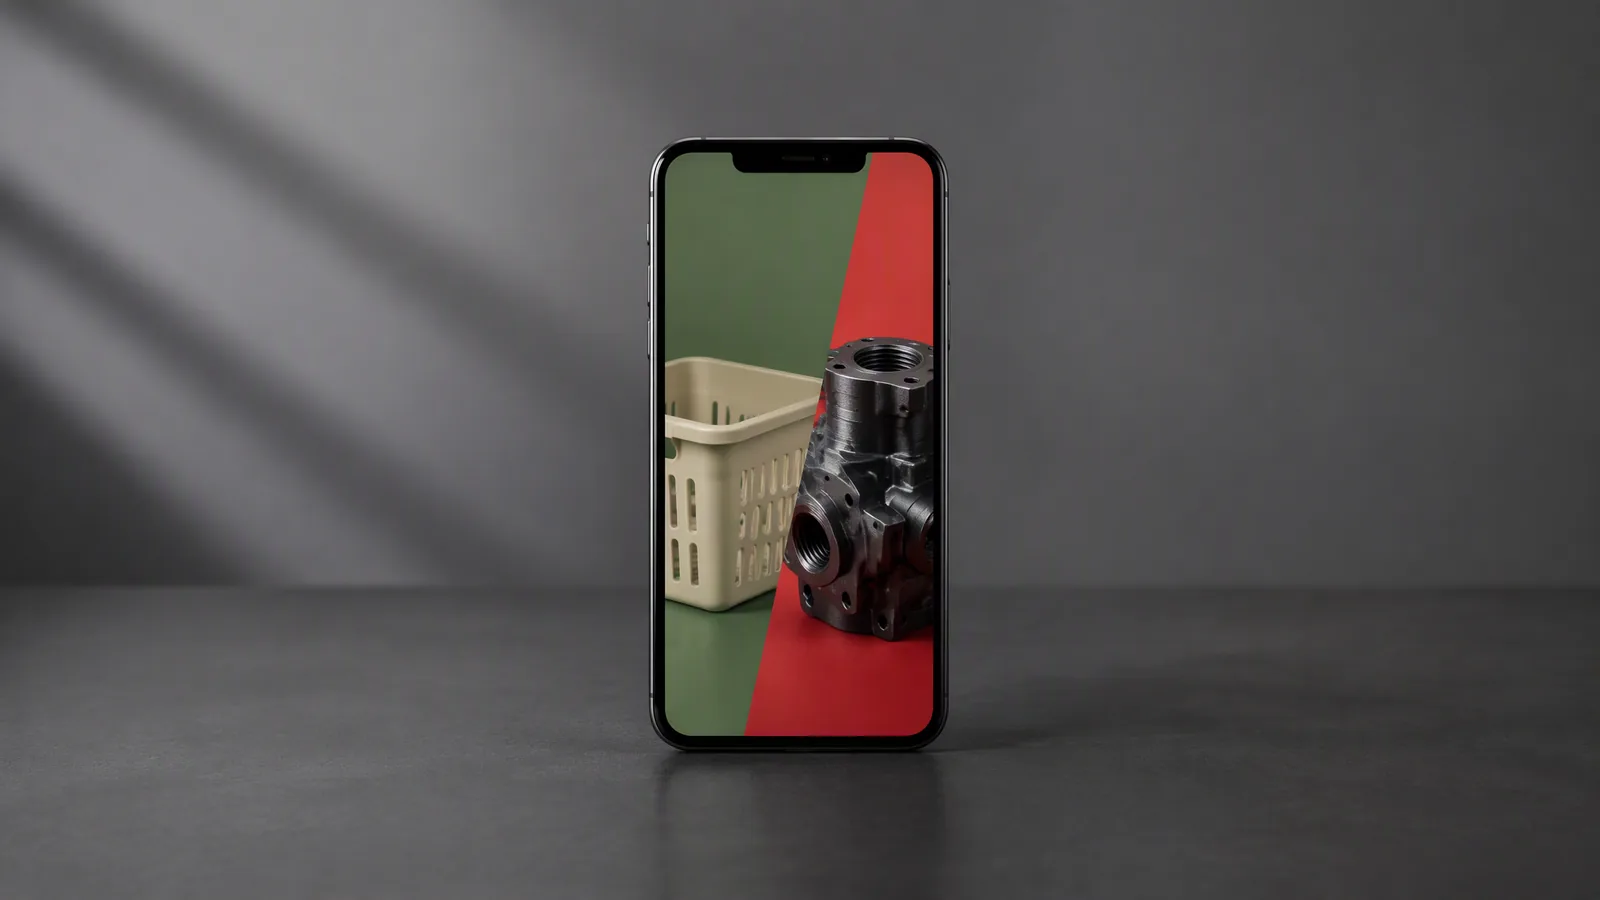
直接给边界:AI 生成的带货视频在"商品外观清晰、动作简单、不依赖精确结构"的场景里可以直接用;在"有可读文字、有精密结构、需要展示多步操作、需要真人口播对口型"的场景里会翻车。 Temu 的视频位以短素材为主,多数商品落在前一类,但踩到后一类的也不少。下面按品类分档,并给出五条自查标准。
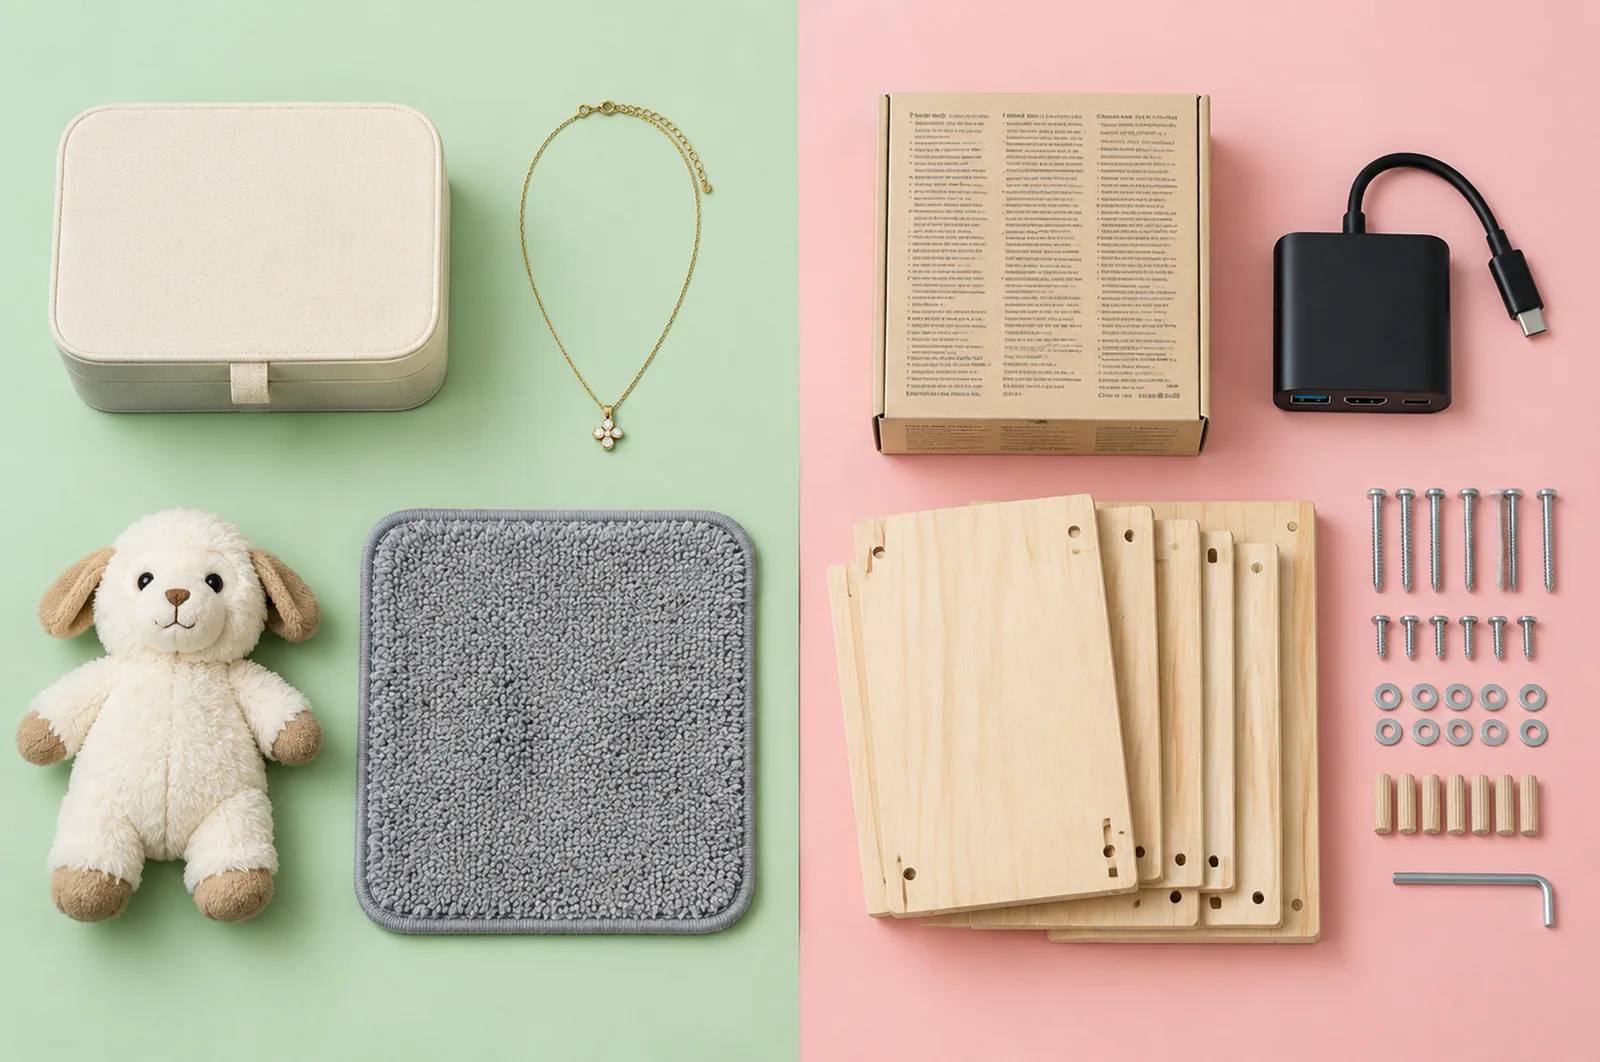
能直接用的类目
这些类目的共同点是:卖点靠外观说话,动作简单。
- 家居百货:收纳盒、地垫、厨房小物。展示摆放、容量、材质即可;
- 服装鞋包(非细节款):整体版型、垂坠、走动效果;
- 宠物用品:玩具、窝垫、食碗,场景感强而结构简单;
- 小饰品:项链、耳环的光泽和佩戴效果;
- 季节性装饰品:氛围重于细节。
这类商品的实测体感是:上传一张商品原图,写一段卖点,选视频类型,一次出片基本可用,返工率低。
容易翻车的类目
- 有可读文字或 logo 的商品。包装正面的文字、说明书上的字,模型生成容易糊成乱码。解法:让文字面背向镜头或被遮挡,需要展示的信息后期贴。
- 精密结构件。数码配件的接口形状、五金件的螺纹、有规则重复结构的零件(齿、孔、格)。生成不稳定,必须逐张核对,返工成本高。
- 多步操作演示。需要"打开→安装→使用"这种连续多步流程的商品(组装家具、复杂厨具),单段视频的时长和连贯性都撑不住。
- 真人口播对口型。需要人物开口说话且口型对得上的场景,目前不建议依赖生成。用"产品演示"或"UGC 种草"类型的旁白式处理更稳。
- 材质是核心卖点。真丝、羊绒、真皮。模型的美化倾向会把材质渲染得过分光滑,买家收货落差大。
实际操作流程与参数
用 PixGT 流光AI 的带货视频功能:传一张商品原图 + 一段卖点 + 选视频类型,分镜和镜头描述由系统内部完成,不需要自己拆分镜。
视频类型 6 种:UGC 种草、带货短剧、产品演示、产品口播、痛点解决、开箱种草。
模型与时长上限:
| 档位 | 计点 | 单段最长 |
|---|---|---|
| Seedance 2.5 | 50 点/秒 | 30 秒 |
| 默认档 768P | 20 点/秒 | 15 秒 |
Temu 的视频位素材通常不需要长片,默认档 768P 的 9~15 秒够用。主推款想要更好的画面素质再上高规格档。
五条判断产出可用与否的标准
按顺序过,任何一条不过就重做。
- 物体形变。全片盯着商品本体看一遍,形状有没有在运动中变形、边缘有没有"呼吸"。这是生成视频最高频的破绽。
- 文字区域。画面里任何文字,默认当作不可用,除非是后期贴上去的。
- 有规则重复的结构。放大数一遍数量:格子几个、扣子几颗、孔位几处。数过再用,不要照着卖点描述写。
- 物理合理性。商品与承托面有没有接触阴影,被拿起时有没有重量感,液体流动方向对不对。
- 颜色与实物的一致性。色偏半档,买家收货就是纠纷。这一条和图片一样,是与实物不符的高发项。
前三条挂了必须重做,后两条可以通过改卖点描述里的材质与色调表述来修正。
重做的成本与策略
按秒计点意味着重做的成本是可预估的:一条 12 秒的默认档视频 240 点,重做一次就是再花一次。比起排期拍摄,这个试错成本很低——所以策略应该是"多出几条挑一条",而不是"精雕一条"。
具体做法:同一个商品用两种视频类型各出一条(比如"产品演示"和"UGC 种草"),比较哪条的画面更稳、更像那个类目该有的样子。批量场景下的流程组织,带货视频怎么批量生成那篇讲得更细;具体到优化转化的要点,可以看亚马逊美妆个护带货视频的优化。
FAQ
Q:Temu 的视频素材有时长要求吗?
各站点和各入口的要求不同,且会调整,以 Temu 卖家后台最新公告为准。生成侧的上限是:Seedance 2.5 最长 30 秒,默认档 768P 最长 15 秒。
Q:需要自己写分镜和镜头描述吗?
不需要。系统内部完成分镜,你提供商品原图、卖点和视频类型即可。
Q:一条视频多少点?
按秒计:默认档 768P 为 20 点/秒,Seedance 2.5 为 50 点/秒。
Q:哪一类商品最不建议用生成视频?
包装正面有大量必须可读文字的商品,以及结构精密的数码配件和五金件。这两类的返工率最高。
Q:怎么降低返工率?
卖点描述写具体,尤其是材质、颜色和使用动作。描述越准,系统扩写出的镜头描述越准。