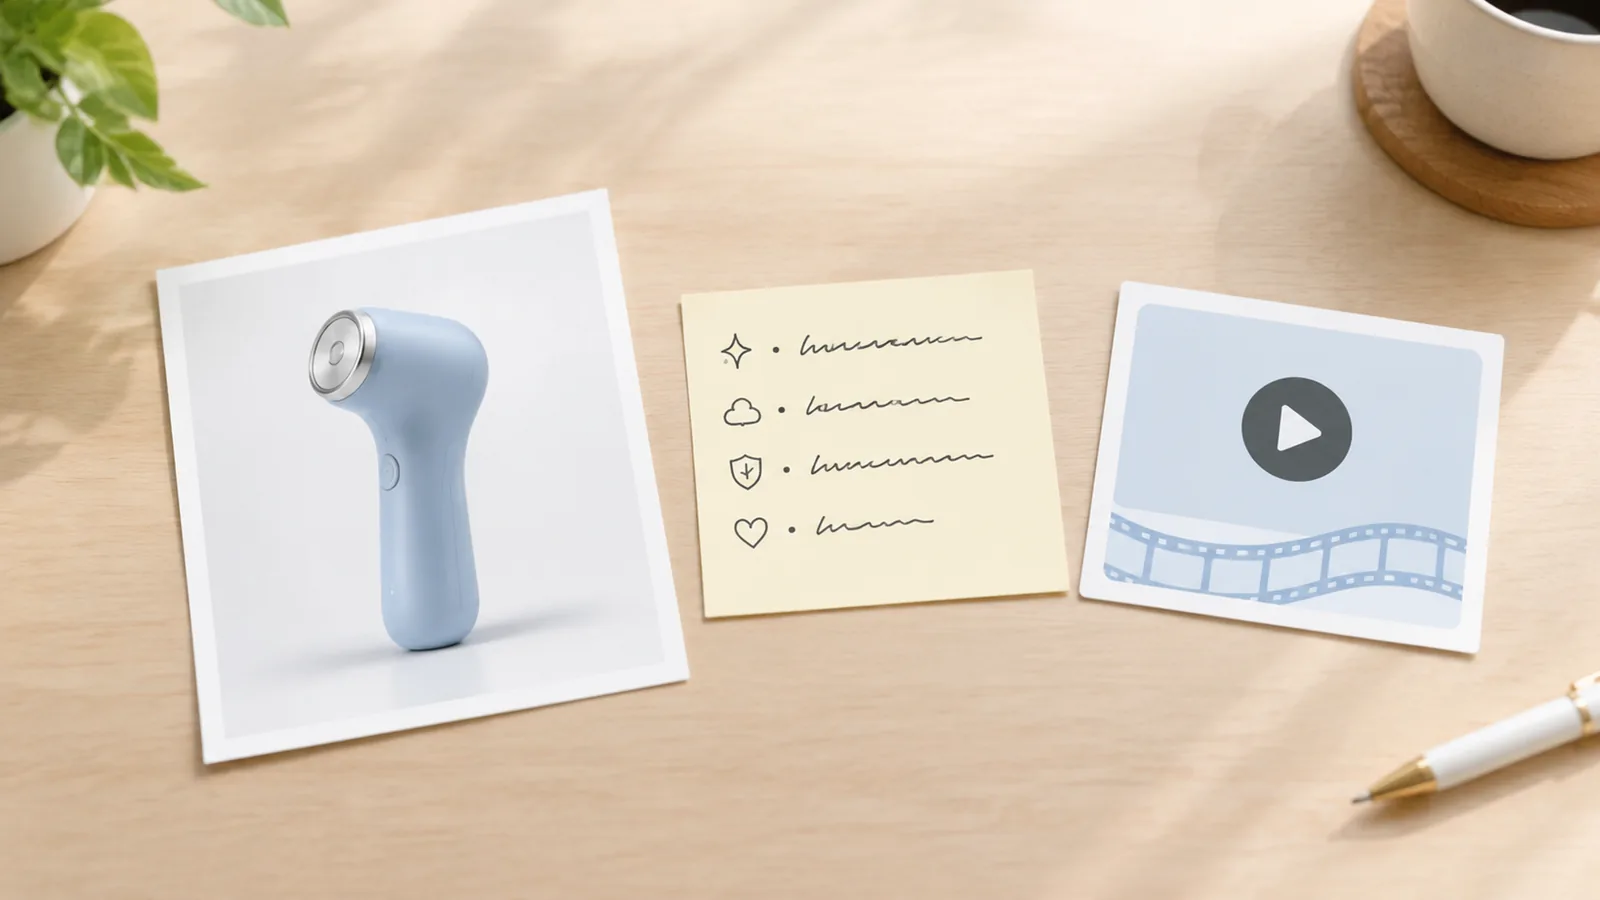
做 AI 带货视频,要准备的只有三样:一张合格的商品原图、一段写实的卖点文字、一个明确的视频类型。不需要分镜脚本、不需要拍素材、不需要配音稿——分镜和镜头描述由系统内部完成。这三样里任何一样偷懒,产出都会明显变差,而且返工的成本远高于前期多花的十分钟。
下面逐项说标准。
一、商品原图:一张就够,但必须合格
只需要 1 张原图。标准如下:
| 项目 | 要求 | 不达标的后果 |
|---|---|---|
| 分辨率 | 1000×1000 像素以上 | 画面全程发虚,放大即穿帮 |
| 主体占比 | 商品占画面 60%~80% | 主体太小,生成时细节被脑补 |
| 背景 | 白底或干净纯色 | 背景杂物会被当成商品的一部分 |
| 光线 | 均匀,无硬阴影、无反光斑 | 后续每一帧的光影都跟着错 |
| 角度 | 最能代表商品的那一面 | 关键卖点在视频里始终不露脸 |
| 完整性 | 商品不被裁切、不被手遮挡 | 缺失部分由模型编造 |
最容易被忽略的是"完整性"。 用手拿着商品拍的图、只露一半的图,模型会自行补全看不见的部分,补出来的形状大概率和实物不一样。宁可用一张平平无奇但完整的白底图,也不要用一张有氛围但缺角的图。
如果手上只有买家秀式的实拍图,先用 PixGT 流光AI 的商品套图功能生成一张干净的白底图,再拿它做视频的输入。
二、卖点文字:这是你唯一能精确控制的地方
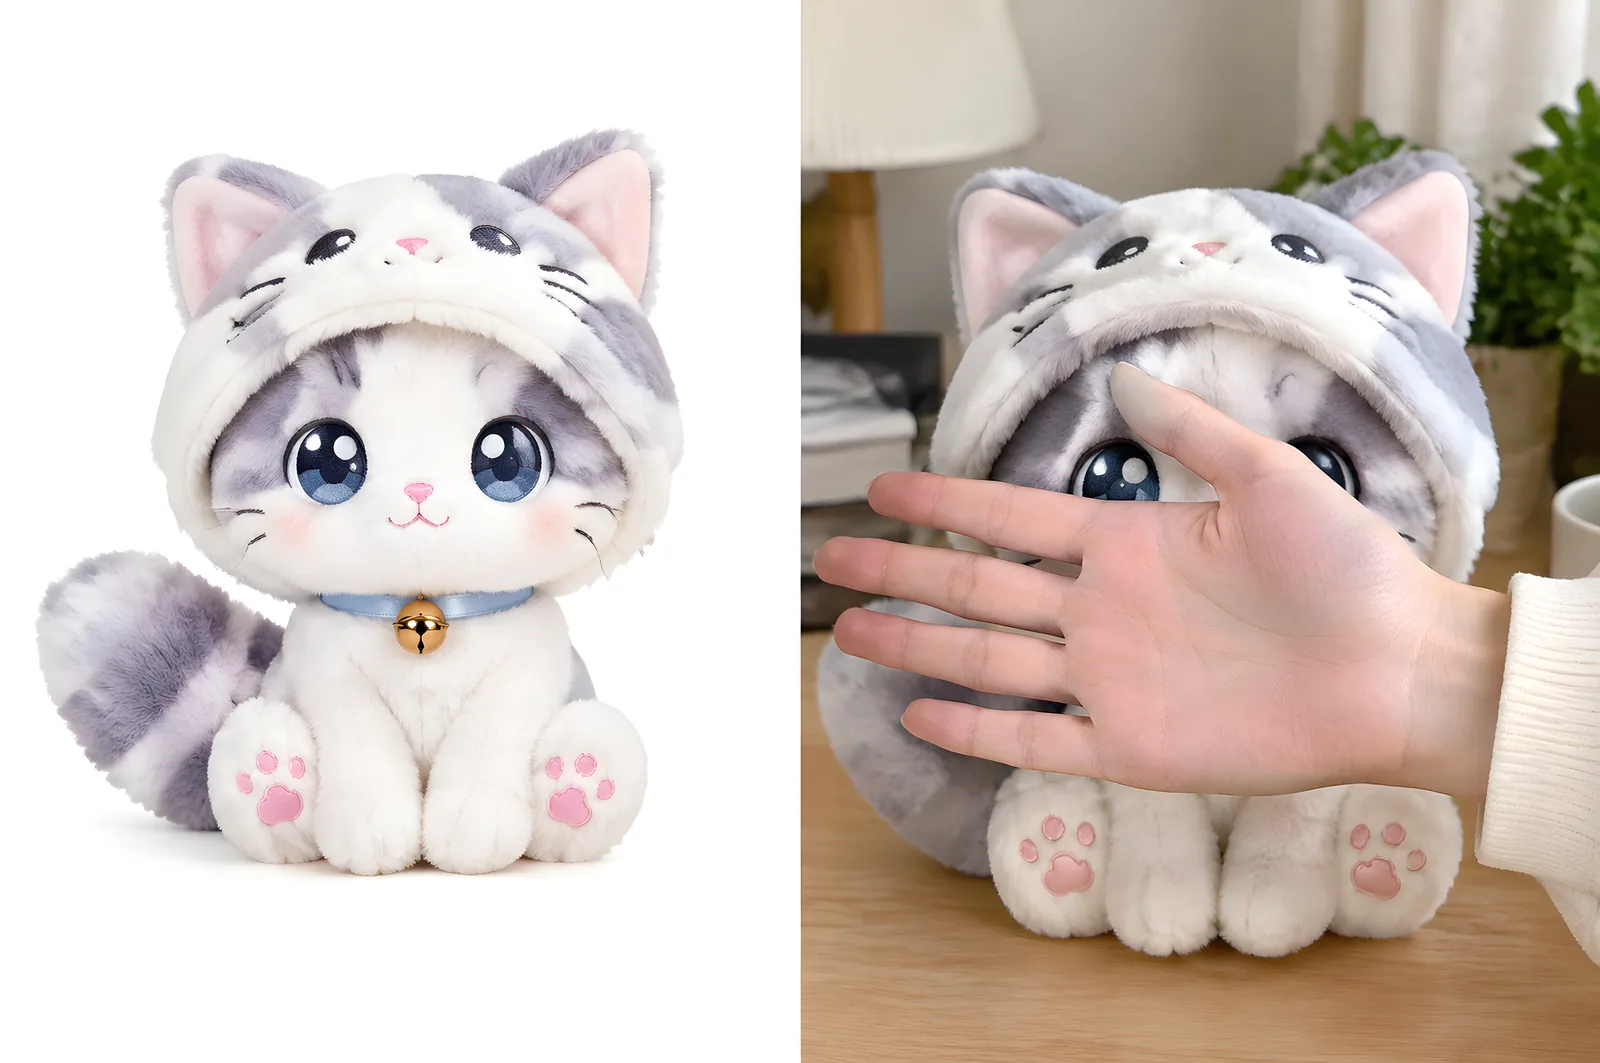
分镜不用写,但卖点文字直接决定系统扩写出什么镜头。写法上有三条硬要求:
- 第一句放最想在开头露出的差异点。 系统扩写时倾向于把靠前的信息安排到靠前的镜头,开头 3 秒是点击率的决定段。
- 每个数字都要实测过。 续航小时数、充电分钟数、承重公斤数——写进去就等于对外承诺,对不上会被判描述不符。
- 写商品能做什么,不写形容词。 “轻便时尚"没有画面,“放进牛仔裤前袋"有画面。系统只能把有画面的句子变成镜头。
长度上,3~5 句、150 字以内比较合适。写太长反而稀释重点,系统会平均分配镜头,每个卖点都讲不透。
不要写的内容:不要要求画面里出现具体文字(AI 生成的画面内文字不可控,中文尤其容易乱码,字幕请后期叠加);不要写虚构的用户评价或使用反馈;不要写"销量第一"“效果最好"这类极限表述。
三、视频类型:6 选 1,别凭感觉选
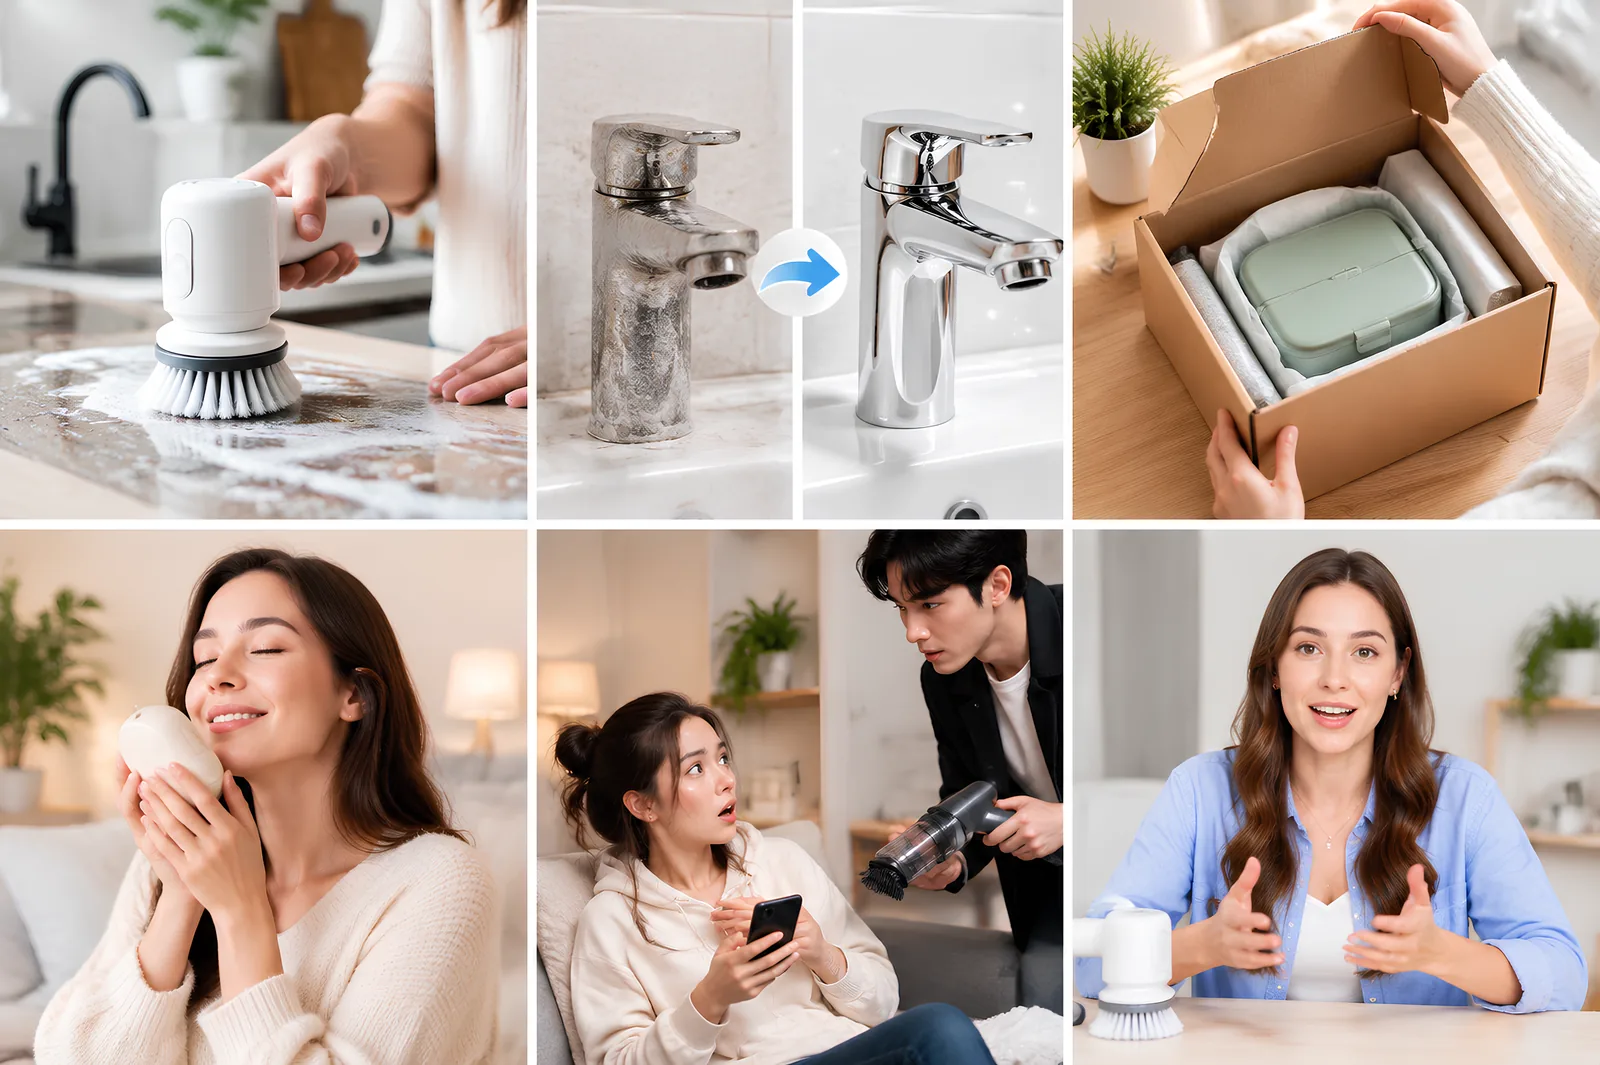
一共 6 种类型,对应的适用场景差别很大:
| 类型 | 适合什么 |
|---|---|
| 产品演示 | 功能、结构、接口这类"看得见"的卖点 |
| 痛点解决 | 先制造问题再给方案,适合解决型商品 |
| 开箱种草 | 有包装质感、配件丰富的商品 |
| UGC 种草 | 服饰、美妆等强调"真人在用"的品类 |
| 带货短剧 | 有使用情境、适合讲故事的家居生活类 |
| 产品口播 | 卖点多、需要逐条陈述的商品 |
选错类型是返工的第一大原因。 一个充电宝选了"带货短剧”,出来的画面全在演生活场景,商品露出不到两秒——素材和文案都没错,就是类型选偏了。
四、还要提前定的两个参数
- 时长与清晰度:默认档 768P 是 20 点/秒、单段最长 15 秒;Seedance 2.5 是 50 点/秒、单段最长 30 秒。信息流投放先用默认档 15 秒(约 300 点),需要展示多步骤操作再上 30 秒。
- 生成几条:同一套素材换不同视频类型出 3 条去测,比一次打磨一条更快找到能跑的版本。
十分钟自查清单
- 原图是不是 1000×1000 以上、白底、商品完整?
- 商品颜色和实物、和链接主图一致吗?
- 卖点文字第一句是不是最强的差异点?
- 里面的数字全都实测过吗?
- 有没有混进形容词堆砌的句子?
- 视频类型和商品属性对得上吗?
- 时长档位选好了吗?
七条全过再点生成,基本不会出现"生成完发现方向就不对"的情况。
FAQ
Q:必须准备视频素材或实拍片段吗? 不需要。一张商品原图就能出片,不用拍视频。
Q:需要自己写分镜和镜头脚本吗? 不需要,这部分由系统内部完成。你能控制的是原图、卖点文字、视频类型和时长档位。
Q:可以上传多张商品图吗? 带货视频只需要一张原图。想覆盖多个角度,更稳妥的做法是先用商品套图把各角度的图做齐,再挑最合适的那张做视频。
Q:素材不合格,生成后能补救吗? 基本不能。画面糊、形状错都是从输入带进去的,只能换图重生成,点数照扣。前期十分钟的自查比事后返工划算得多。
Q:不同平台的素材要求一样吗? 输入素材的标准是一样的,差别在成片的节奏和本地化。平台侧的规则以各平台最新公告为准,具体可参考Temu 数码带货视频怎么优化?提升转化的几个要点。